Внимание: для входа на форум используйте e-mail вместо ника, пароль остаётся прежним. Если вы забыли свой e-mail пишите в техподдержку ( MFadmin@bk.ru )


nsg
-
Постов
99 -
Зарегистрирован
-
Посещение
Тип контента
Профили
Галерея
Блоги
События
Магазин
Загрузки
Форумы
Весь контент nsg
-
Крис Паппас, Уильям Мюррей Visual C++ 6. Руководство разработчика Данное учебное пособие поможет вам научиться создавать 32-разрядные приложения Windows в среде Microsoft Visual C++ 6. Книга содержит подробное описание языков С и С++, сопровождаемое множеством советов и легких для понимания примеров, с акцентом на особенности реализации этих языков в компиляторе Microsoft Visual C++. Последовательно проводится сравнение языков С и С++, а также анализируются различия в подходах к написанию процедурных и объектно-ориентированных программ. Кроме того, в книге рассматриваются базовые принципы программирования в среде Windows - от создания простых процедурных приложений на языке С до сложных объектно-ориентированных программ, написанных на С++ с использованием библиотеки MFC. Отдельные главы посвящены технологии OLE, созданию элементов управления ActiveX и библиотеке Active Template Library (ATL). Visual C++ 6. Руководство разработчика.rar

-
Адрес переменной Операционная система Windows выделяет каждой программе 4 Гб адресного пространства. В реальности, конечно, такой оперативной памяти нет (хотя кто знает, что будет через пару-тройку лет ;)), но каждая программа искренне думает, что у нее есть столько места. Каждый байт адресного пространства имеет свой адрес. Адрес - это просто некоторое число. В Windows адрес выглядит приблизительно так: 0x0D56FF23. Тут префикс 0x означает что это число в шестнадцатеричном виде. Цифры шестнадцатеричного числа - это обычные числа от 0 до 9 и буквы A, B, C, D, E, F. Обратите внимание, что в адресе 8 знаков (так и должно быть, так как у каждой программы 4 Гб адресного пространства). Рассмотрим подробнее, что происходит, когда вы пишете в вашей программе что-то вроде int z; В этом случае в адресном пространстве вашей программы несколько байт (а именно столько, сколько надо на хранение одного целого - скорей всего это будет 4 байта) получают имя z. И это очень удобно - запись в эти ячейки идет не по их адресу (который выглядит как-то вроде 0x00FD240A) а по удобному имени z. Эти байты выделяются в определенном месте адресного пространства. Адрес первого байта нашего числа z будет начальным адресом все переменной z. Адрес можно получить непосредственно. Для этого служит оператор взятия адреса & (называется амперсанд). Вот пример: int z; cout<<&z; //Выводим на экран адрес переменной z. Указаный фрагмент выведет что-то вроде 0x0012FF7C. Вот еще пример: int z[3]; //Массив cout<<z; //Адрес начального элемента массива. Тут выведется адрес начала массива (т. е. адрес его нулевого элемента). Таким образом имя массива - это адрес его начала.
-
Встраиваемые (inline) функции При компиляции тело функции не повторяется - т. е. при первом приближении оно имеется только в одном месте программы, и при вызове функции происходит переход на тело функции, которая и выполняется. При этом есть как плюсы, так и минусы. Плюс тот, что размер exe-файла получается не такой большой (функция-то занимает место только один раз), а минус - то, что программа работает несколько медленнее, так как тратится дополнительное время на переход к телу функции. Встраиваемые (inline) функции как раз и решают эту проблему. Оформляется такая функция как и обычная, только с ключевым словом inline. Но при компиляции тело функции подставляется во все места ее вызова. Минусы и плюсы тут меняются местами по сравнению с обычной функцией: вызов такой функции идет быстрее, а место exe-файл занимает больше. Вот пример: ... //Встраиваемая функция. inline int f(int a, int b) { return a*b; } void main() { //Вызов функции. cout<<f(23, 45)<<"\n"; cout<<f(-23, 77)<<"\n"; } Надо сказать, что разные компиляторы по-разному работают с inline-функциями. Если компилятор не может сделать функцию встраиваемой, то он делает ее обычной. Например, такое может случится с рекурсивной функцией.
-
Либерти, Джесс, Хорват, Дэвид Освой самостоятельно C++ за 24 часа Здесь изложены фундаментальные основы программирования на языке C++, описаны принципы управления вводом-выводом, циклы, массивы, объектно-ориентированные подходы, а также создание полнофункционального приложения. Все главы содержат листинги программ, результаты их выполнения и анализ кода. Приведены ответы на часто задаваемые вопросы, а также упражнения и контрольные вопросы. Изложение книги не предполагает наличия у читателя предварительных знаний в области C++, а четкая организация материала позволит быстро и просто изучить язык. Либерти, Джесс, Хорват, Дэвид Освой самостоятельно C++ за 24 часа.rar

-
Красиков И.В. Алгоритмы. Просто как дважды два У вас в руках краткий справочник по компьютерным алгоритмам. Если вам понадобилось написать программу, решающую какую-то задачу, возможно, эта книга поможет вам, подсказав, какой именно алгоритм лучше всего использовать. В книге собраны самые разные алгоритмы - от сортировки работы с графами до численных методов и работы с календарем; имеется много примеров использования алгоритмов для решения конкретных задач, а также реализация описанных алгоритмов на языке программирования C++. Красиков И.В. Алгоритмы. Просто как дважды два.rar

-
Директивы препроцессора #include <iostream.h> Это так называемая директива препроцессора. Все директивы препроцессора начинаются с символа #. Конкретно директива include нужна для включения некоторого файла в вашу программу. Тут мы включаем файл iostream.h. Он нужен для того, чтобы мы в нашей программе могли что-ниюудь вводить с клавиатуры или выводить на экран. Этот include пишется почти всегда. После директив препроцессора точка с запятой не ставится. До компиляция (т. е. превращение в машинные коды) вашей программы происходят некоторые действия - а именно сначала выполняются так называемые директивы препроцессора, а уже потом - непосредственно компиляция. Директивы препроцессора могут, например, включать в файл вашей программы другие файлы (это мы делаем с помощью директивы #include), определять некоторые константы (директива #define) и многое другое. Важно понимать, что все директивы препроцессора выполняются до этапа компиляции. После выполнения директив препроцессора текст вашей программы будет изменен (не в исходном файле, конечно - там все как было, так и останется). Перед любой директивой препрцессора пишется знак #. Давайте немного приоткроем покров над тайной директив препроцессора на маленьком примере. Этот пример будет специфичен для Visual C++, но это не должно нас особенно тревожить - сейчас нам важно просто понять, как это все работает. Итак, создайте на Visual C++ новый проект для консольного приложения Для файла *.cpp задайте имя test.cpp. В качестве текста программы введите #include "test2.h" #define pi 3.14 void main() { float z=2*pi; } Пока текст нас не слишком должен волновать. Если не все понимаете в тексте - не беда. Принцип здесь такой - #include влючает указанный файл в наш файл. У нас это файл test2.h. Создайте его (например в Блокноте) в той же папке, где находятся все остальные файлы вашего проекта. В нем напечатайте следующий текст (на самом деле можно напечатать все что угодно - это не принципиально): struct v{ int x, y; }; Еще одна директива препроцессора в нашей программе - это #define. Она просто пределяет константу pi, которую мы парой строчек ниже используем. Теперь для просмотра того, что получается после выполнения директив препроцессора, измените настройки нашего проекта. Нажимайте Alt+F7 (или меню Project и далее Settings) и переходим на вкладку C/C++. В ней меняем содержимое окошка Project Options: Из этого окошка все удалите, и напечатайте там /MLd /Fo"Debug/" /P Пока мы это обсуждать не будем, отметим только, что с такими параметрами вы получите в папке проекта файл с результатом работы препроцессора. Закройте окно настроек нажав на OK. Компилируем программу (клавиша F7). В папке с файлами проекта появится файл test.i со следующим текстом: #line 1 "D:\\_programming\\cpp\\test\\test.cpp" #line 1 "D:\\_programming\\cpp\\test\\test2.h" struct v{ int x, y; }; #line 2 "D:\\_programming\\cpp\\test\\test.cpp" void main() { float z=2*3.14; } Как вы видите, препроцессор поработал - вставил файл test2.h в наш файл и заменил pi на значение константы: ... float z=2*3.14; Так что работу препроцессера мы немного посмотрели.

-
Пространство имен Пространство имен (namespace) является фундаментальной концепцией C++. Пространство имен - это группа имен, в которой имена не совпадают. Исключением являются имена перегружаемых функций и переменные с различными областями действия. Имена в различных пространствах имен не конфликтуют. Например, можно использовать имя my_adress в двух различных классах (это же относится к структурам и объединениям). C++ также позволяет определить пространства имен при помощи ключевого слова namespace . Такие пространства имен вводятся для снижения вероятности конфликта имен и полезны в случае использования имен из нескольких различных библиотек. Спецификатор namespace определяет пространство имен функций, классов и переменных, находящихся в отдельной области видимости. Вообще namespace определяет группу символов, представляющих собой названия или имена функций, классов или переменных. Примером такого определения области видимости является область видимости членов класса. Синтаксис: namespace name { // объявления и определения имен } Аргументом спецификатора namespace (то есть name ) является идентификатор пространства имен. Чтобы обратиться к чему-нибудь в пространстве namespace_name, достаточно обратиться непосредственно к члену, используя оператор определения области видимости (::): namespace_name::member . Однако, при многократном использовании члена member такая запись становится слишком громоздкой. Инструкция using заставляет компилятор признавать дальнейшее использование этому члену пространства namespace_name без дополнительного определения имени этого пространства: using namespace_name::member; Инструкция using namespace заставляет компилятор признавать все члены пространства имен namespace_name: using namespace namespace_name; В приведенном ниже примере глобальные переменные Cary и Hugh объявляются в пространстве имен grants: namespace grants { int Cary = 0; int Hugh = 1; } Вне пространства имен grants переменные могут быть упомянуты как grants::Cary и grants::Hugh. Но можно сократить эту запись, если добавить такую инструкцию: using grants::Cary; Теперь имя Cary может использоваться в последующих инструкциях без дополнительного определения. Чтобы иметь возможность ссылаться на обе переменные без определения имени пространства, достаточно написать using namespace grants;
-
Лаптев В. В. С++. Объектно-ориентированное программирование. Задачи и упражнения. Книга предназначена для изучения возможностей объектно-ориентированного стиля программирования на языке С++. Приведены сведения о синтаксисе и семантике объектно-ориентированных конструкций С++, стандартной библиотеке шаблонов STL. Книга содержит необходимые теоретические сведения, упражнения и задачи для самостоятельной работы, справочную информацию по наиболее популярным средам программирования: С++ Builder 6 и Visual C++.NET 2003. Для преподавателей и студентов, начинающих программистов. Допущено Министерством образования и науки Российской Федерации в качестве учебного пособия для студентов высших учебных заведений, обучающихся по направлению подготовки «Информатика и вычислительная техника». Лаптев В. В. С++. Объектно-ориентированное программирование. Задачи и упражнения.rar

-
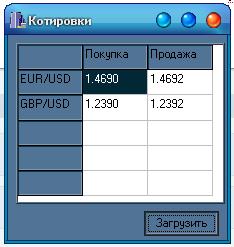
Практическое занятие №3 Экспорт котировок с помощью индикатора BidAsk (Окончание) Запускаем компилятор. Если кто еще не поставил его себе как ставить смотрим тут После запуска откроется пустая форма. Переименуем её. Зайдем в свойста формы "Caption" и напишем "Котировки"(хотя название программе можно дать любое) см. рис 1. Рисунок 1 Далее на форму добавляем кнопку(Button1). Кнопка находиться на закладке Standard(см. рис 2). И добавляем StringGrid1 с закладки Additional(см. рис.2). Теперь начнем писать код. Щелкнем по нашей кнопке 2 раза и наш компилятор автоматически создаст событие(нажатие на кнопку). Вот как это выглядит. void __fastcall TForm1::Button1Click(TObject *Sender) { } TStringList *Table1 = new TStringList ; //создадим (вручную) вспомогательную таблицу Table1->LoadFromFile("С:\\Program Files\MetaTrade 4\expert\files\BidAsk.txt") ; //загружаем в нашу вспомогательную таблицу файл BidAsk.txt проверьте правильность пути StringGrid1->Cells[1][0] = "Покупка"; //Заполняем шапку(название колонок покупка и продажа) StringGrid1->Cells[2][0] = "Продажа"; //обратите внимание Cells[1][0] - это колонки StringGrid1->Cells[0][1] = "EUR/USD"; //Заполняем название валют StringGrid1->Cells[0][2] = "GBP/USD"; //Здесь вам будет необходимо добавить 3 недостающие валюты int p=1; // объявляем вспомогательную переменную for(int i = 0 ; i<4 ; i++)/здесь загружаем 4 котировки(2 покупки и 2 продажи) здесь тоже надо кое- что поменять { // Копируем (построчно) данные с StringGrid1->Cells[1][p]= Table1->Strings; // вспомогательной табл. в StringGrid1. это строчка покупка i++ ; //увеличиваем i на 1 StringGrid1->Cells[2][p]= Table1->Strings ; //это строчка продажа p++; //увеличиваем р на 1 } Вот собственно и весь код. Теперь уменьшим форму и у кнопке в свойстве "Caption" напишем Загрузить(см. рис. 3) Рисунок 3 Исходники проекта Котировки.rar Домашнее задание Дописать котировки для остальных валютных пар.


-
Березин Б.И, Березин С.Б Начальный курс C и C++ Книга является учебным пособием по языкам программирования С и C++. Она может быть использована для изучения языка С, как самостоятельного языка. Язык C++ рассматривается как надстройка к языку С. Изложение проиллюстрировано большим количеством примеров. Книга написана на основе учебного курса "C++ для начинающих", который в течение нескольких лет читался в учебном центре "Диалог-МИФИ" и ориентирована на начинающих программистов, а также тех, кто хочет самостоятельно изучить языки программирования С и C++. Она также может быть полезна для читателей, знающих язык С и начинающих изучать C++. Березин Б.И, Березин С.Б Начальный курс C и C++.rar

-
Дирк Хенкеманс, Марк Ли Программирование на C++ Для тех, кто мало знаком с программированием, но ищет хороший учебник по C++, эта книга станет идеальным выбором.Написанная профессиональными разработчиками и отличающаяся легким стилем изложения, она обучает принципам программирования на примерах создания простых игр. Прочитав ее, вы приобретете навыки, необходимые для создания более сложных программ на C++, и узнаете, как использовать их в реальных приложениях. Изучите многочисленные приемы, которые применимы не только к C++, но и к программированию в целом, поэтому полученные знания будут вам полезны при освоении других языков программирования. Вы узнаете, что такое переменные и управляющие операторы, функции и объектно- ориентированное программирование, пространства имен и массивы. Научитесь программировать для Windows, создавать программы шифрования, отлаживать ошибки и грамотно обрабатывать исключения, эффективно использовать потоки и файлы, а также разрабатывать игры с помощью библиотеки DirectX. Оглавление: 1. Путешествие начинается 2. Продолжаем погружение: переменные 3. Принимайте командование: управляющие операторы 4. Пишем функции 5. Боевые качества ООП 6. Сложные типы данных 7. Градостроение и пространства имен 8. Наследование 9. Шаблоны 10. Потоки и файлы 11. Ошибки и обработка исключений 12. Программирование для Windows 13. DirectX 14. Создаем пиратское приключение Хенкеманс, Ли - Программирование на С++ (OCR).rar

-
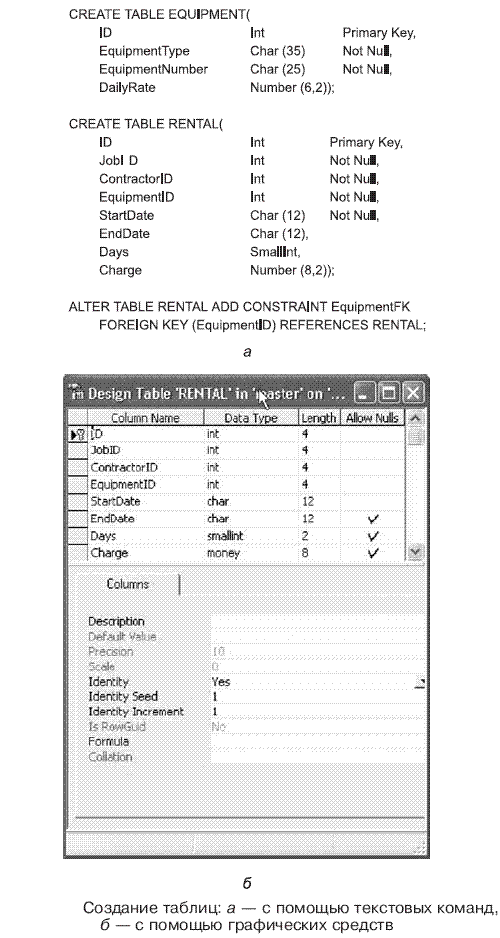
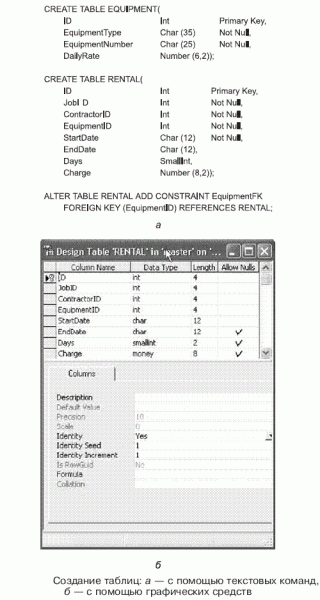
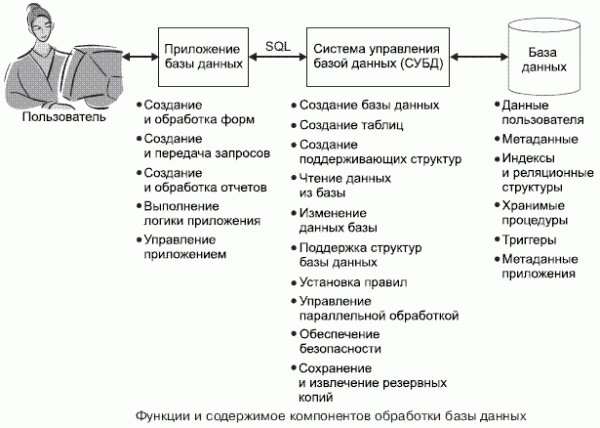
Краткая история баз данных (Продолжение) СУБД для персональных компьютеров С появлением большого числа микрокомпьютеров стало возможно иметь персональные базы данных. В результате был разработан ряд СУБД для персональных компьютеров. Наиболее успешной из них была dBase — продукт корпорации Ashton-Tate. Еще среди ранних персональных СУБД можно назвать R:base корпорации Microrim и Paradox от Borland. Поскольку компьютеры обладали довольно большой вычислительной мощностью, персональные СУБД предоставляли больше графических интерфейсов пользователя. Кроме того, со временем под влиянием этих продуктов изменились и интерфейсы больших организационных СУБД. На рис. 2 показан этот момент. Технология того, что показано на рис. 2(а), разрабатывалась для символьноориентированных интерфейсов, которые были распространены для СУБД, предшествовавших персональным компьютерам. На рис. 2(б) показан пример графического интерфейса, который появился с возникновением персональных СУБД. Рисунок 2 Объектно-ориентированные СУБД Объектно-ориентированное программирование начало развиваться в середине восьмидесятых годов прошлого века и привело к созданию объектно-ориентированных СУБД. Целью этих продуктов была способность хранить объекты из объектно-ориентированного программирования (например, из языков С++ или Java) в базе данных, не преобразуя их в реляционный формат. В настоящее время ООСУБД не имеют коммерческого успеха. Их использование требует от организаций преобразовывать свои базы данных из реляционного в ООСУБД-формат. Кроме того, большинство крупных организаций имеют более старые приложения, не основанные на объектно-ориентированном программировании. Программы в таких приложениях потребовалось бы как-то сопровождать новыми ООСУБД. Таким образом, высокая стоимость перевода существующих баз данных и информационных систем из реляционных СУБД в ООСУБД задерживает их широкое распространение. Были разработаны объектно-ориентированные СУБД, такие как Oracle 8i и 9i, что позволило создавать как реляционное, так и объектное представление данных одной и той же базы данных. Эти СУБД начинают получать коммерческий успех, но не такой, как чисто реляционные СУБД. Недавняя история В 1991 году Microsoft выпустила Access, который на несколько лет вытеснил с рынка все остальные СУБД. Частично это произошло благодаря тому, что Access был интегрирован в Microsoft Office, и Microsoft смогла использовать свое влияние на рынке и монополию в связи с Windows для смещения других продуктов. Правда, Microsoft нужно отдать справедливость: Access — суперпродукт. Он доминирует на рынке, потому что это легкая в использовании и сильная СУБД. Как все знают, использование Интернета распространилось в середине девяностых годов. Но немногие знают, что именно это сильно повысило значение и важность технологии баз данных. Как только ранние статические веб-страницы уступили дорогу динамическим, как только стали иметь успех компании типа Amazon.com и как только большие организации начали использовать Интернет для публикации своих данных, все большее и большее количество сайтов стало зависеть от баз данных. Эта тенденция продолжается и по сей день. Наконец, в последние годы появился и стал широко использоваться язык XML, который представляет собой технологию для поддержки веб-сайтов, но был расширен для проведения важных решений, связанных с базами данных. Интеграция технологии баз данных с XML является ведущим пунктом области баз данных сегодня и будет важна еще много лет в будущем. Заключение Хотя обработка баз данных всегда была важной темой, популярность Интернета сделала ее еще и одной из самых нужных специальностей. Цель базы данных — помочь людям и организациям вести учет различных вещей. Хотя для этой цели можно использовать списки, они вызывают множество проблем. Их сложно изменять без возникновения несоответствий, удаления из списков могут иметь непредвиденные последствия, а неполные данные трудно записывать. Кроме того, вводя данные, легко вызвать их противоречивость. Наконец, различные части организации хотят поддерживать некоторые данные совместно, а некоторые — исключительным образом. Это трудно организовать при использовании списков. Базы данных состоят из групп реляционных таблиц. В большинстве случаев каждая таблица содержит данные по определенной теме. Поддержка данных таким образом решает все проблемы, перечисленные для списков. Связи в таблицах представляются разными способами. Таблицы можно создавать с помощью языка SQL, который является промышленным стандартом для обработки таблиц. Система базы данных состоит из четырех основных элементов: пользователи, приложения базы данных, СУБД и сама база данных. Пользователи применяют базу данных для решения своих задач. Приложения производят формы, запросы и отчеты, выполняют логику приложения и управляют обработкой базы. СУБД создает, обрабатывает и администрирует базу данных. База данных — это самодокументированное собрание интегрированных записей. Она содержит пользовательские данные, метаданные, индексы, хранимые процедуры, триггеры и метаданные приложения. Хранимая процедура — это программа, которая обрабатывает участок базы данных и хранится в базе данных. Триггер — это процедура, которая вызывается при наступлении определенного события. На рис. 3 показаны функции компонентов базы данных. Рисунок 3 Технология баз данных может использоваться в широком спектре приложений. Некоторые базы данных используются одним человеком, другие — группой людей, а третьи — большими организациями. Подобно всем информационным системам, системы баз данных разрабатываются в течение трех фаз: формулирования требований, проектирования и реализации. Во время фазы формулирования требований разрабатывается модель данных, или логическое представление структуры базы данных. Модели данных важны, потому что от них зависит проектирование базы данных и приложения. Диаграмма сущность—связь — средство, используемое для представления модели данных. Модель данных преобразуется в таблицы и связи на фазе проектирования. Также проектируются индексы, ограничения, хранимые процедуры и триггеры. Диаграммы структур данных иногда используются для таблиц документов и их связей. Во время фазы реализации создаются таблицы, связи и ограничения, пишутся хранимые процедуры и триггеры, база данных заполняется данными и тестируется. Сегодня таблицы и связанные с ними конструкции создаются с помощью SQL или графических средств, являющихся частью СУБД.
-
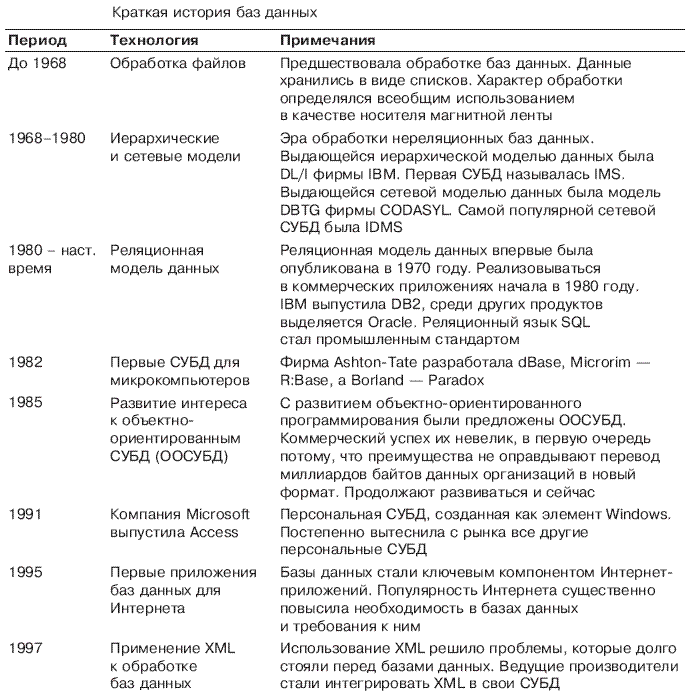
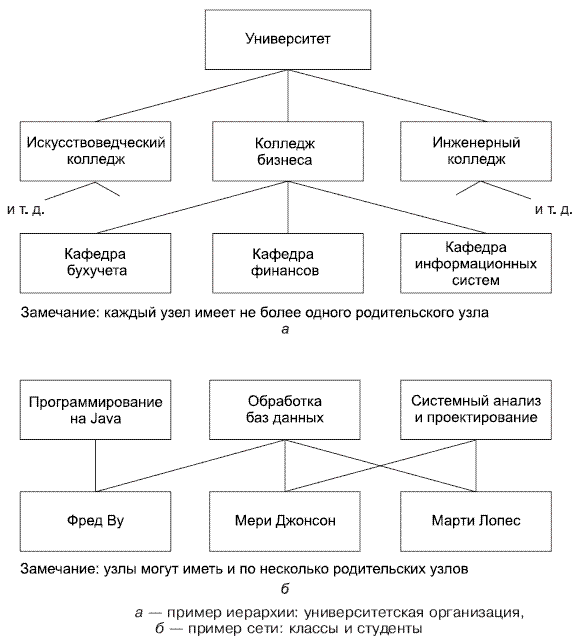
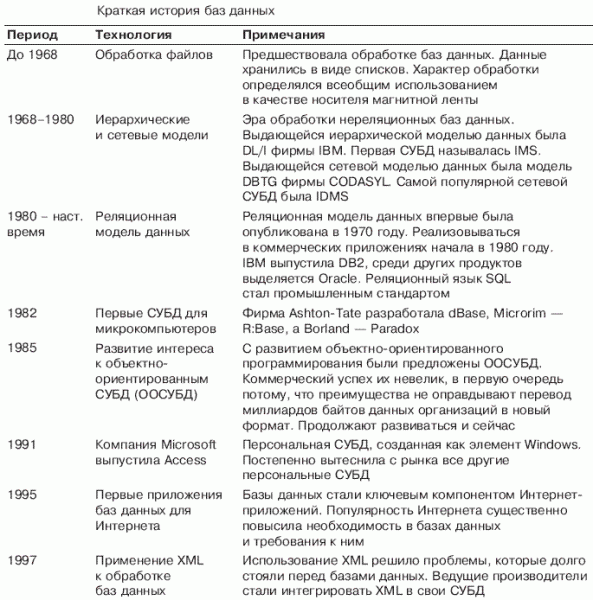
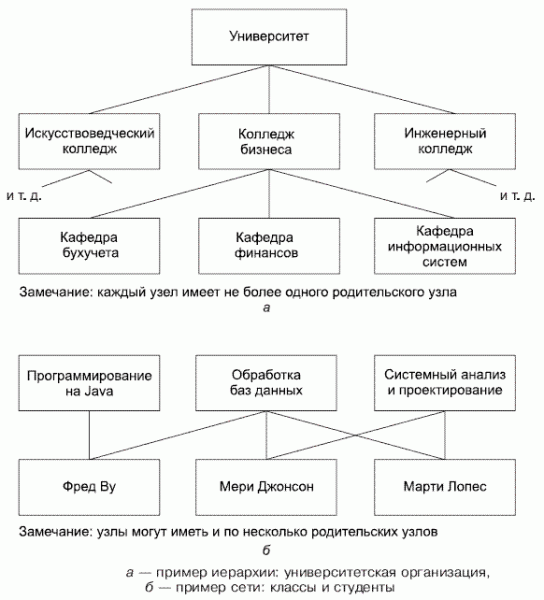
Краткая история баз данных В табл. 1 сведена история развития технологии баз данных. До середины 1960-х годов почти все компьютерные хранилища данных были на магнитных лентах. Поскольку лента может обрабатываться только последовательно, данные должны были храниться в виде списков (или последовательных файлов, как они назывались). Однако, как вы узнали в начале этой главы, хранение даже простейших данных в таком формате чревато большими проблемами. Таблица 1 Ранние модели баз данных С коммерческим успехом хранилищ на дисках в середине 1960-х стало возможным получение непоследовательного, или прямого, доступа к записям. Базы данных стали разрабатываться по-другому. Изначально стали успешными две конкурирующие архитектуры, или модели. Корпорация IBM разработала и внедрила DL/I (Data Language One, язык данных один), который моделировал данные в базах данных в форме иерархий, или деревьев (см. рис. 1.а). Эта модель, которая была разработана совместно с промышленными предприятиями, легко могла использоваться для поддержки данных, таких как сметы материалов и списки деталей, но для общих целей мало подходила. Представление неиерархических сетевых данных (рис. 1.б) было громоздким. После этого CODASYL, группа, которая разрабатывала стандарты для языка COBOL, в 1970 году создала модель под названием DBTG (Data Base Task Group, группа задач баз данных). Модель DBTG была готова к представлению как иерархических, так и сетевых данных. Один раз эта модель предлагалась в качестве национального стандарта, но не была принята в первую очередь из-за своей сложности. Однако это была основа для ряда коммерчески успешных СУБД в семидесятых и восьмидесятых годах прошлого века. Наиболее успешным был продукт корпорации Cullinane под названием IDMS. Рисунок 1 Реляционная модель Реляционная модель, которая впервые была предложена Е. Ф. Коддом в 1970 году. Кодд работал в IBM, и после десяти лет исследований, разработки и лоббирования на уровне корпорации он с коллегами убедил IBM разработать несколько СУБД, основанных на реляционной модели. Наиболее известным из этих продуктов является DB2 — СУБД, которая активно используется и поныне. Между тем другие корпорации (такие как Oracle, Ingres, Sybase и Informix) тоже разработали СУБД, основанные на реляционной модели. SQL Server был разработан в Sybase и в конце восьмидесятых годов продан Microsoft. Сегодня DB2, Oracle и SQL Server являются наиболее выдающимися коммерческими СУБД.
-
Будущее развитие Си++ продолжает развиваться, чтобы отвечать современным требованиям. Одна из групп, занимающихся языком Си++ в его современном виде и направляющих комитету по стандартизации Си++ советы по его улучшению — это Boost. Например, одно из направлений деятельности этой группы — совершенствование возможностей языка путём добавления в него особенностей метапрограммирования. Стандарт Си++ не описывает способы именования объектов, некоторые детали обработки исключений и другие возможности, связанные с деталями реализации, что делает несовместимым объектный код, созданный различными компиляторами. Однако для этого третьими лицами создано множество стандартов для конкретных архитектур и операционных систем. Тем не менее (по состоянию на время написания этой статьи) среди компиляторов Си++ всё ещё продолжается битва за полную реализацию стандарта Си++, особенно в области шаблонов — части языка, совсем недавно полностью разработанной комитетом стандартизации. Одной из точек преткновения в этом вопросе является ключевое слово export, используемое также и для разделения объявления и определения шаблонов. Первым компилятором, поддерживающим export в шаблонах, стал Comeau C++ в начале 2003 года (спустя пять лет после выхода стандарта). В 2004 году бета-версия компилятора Borland C++ Builder X также начала его поддержку. Оба этих компилятора основаны на внешнем интерфейсе EDG. Другие компиляторы, такие как Microsoft Visual C++ или GCC, вообще этого не поддерживают. Эрб Саттер (Herb Sutter), секретарь комитета по стандартизации Си++, рекомендовал убрать export из будущих версий стандарта по причине серьёзных сложностей в полноценной реализации, однако впоследствии окончательным решением было решено его оставить. Из списка других проблем, связанных с шаблонами, можно привести вопросы конструкций частичной специализации шаблонов, которые плохо поддерживались в течение многих лет после выхода стандарта Си++.
-
Отличия С++ от С Язык Си++ во многом является надмножеством Си. Новые возможности Си++ включают объявления в виде выражений, преобразования типов в виде функций, операторы new и delete, тип bool, ссылки, расширенное понятие константности, подставляемые функции, аргументы по умолчанию, переопределения, пространства имён, классы (включая и все связанные с классами возможности, такие как наследование, функции-члены виртуальные функции, абстрактные классы и конструкторы), переопределения операторов, шаблоны, оператор ::, обработку исключений, динамическую идентификацию и многое другое. Язык Си++ также во многих случаях строже относится к проверке типов, чем Си. В Си++ появились комментарии в виде двойной косой черты («//»), которые были в предшественнике Си — языке BCPL. Некоторые особенности Си++ позднее были перенесены в Си, например ключевые слова const и inline, объявления в циклах for и комментарии в стиле Си++ («//»). В более поздних реализациях Си также были представлены возможности, которых нет в Си++, например макросы vararg и улучшенная работа с массивами-параметрами. Не объектно-ориентированные возможности В этом разделе описываются возможности, непосредственно не связанные с объектно-ориентированным программированием (ООП). Многие из них, однако, особенно важны в сочетании с ООП. Описатель inline означает, что функция является хорошим кандидатом на оптимизацию, при которой в местах обращения к функции компилятор вставит тело этой функции, а не код вызова. Пример: inline double Sqr(double x) {return x*x;} Вместо функций malloc и free (которые оставлены только для обратной совместимости), введены новые операции new и delete. Если T — произвольный тип, то new T выделяет память, достаточную для размещения одного объекта типа Т, возможно, инициализирует объект в этой памяти, и возвращает указатель типа Т*. new T[n] выделяет память, достаточную для размещения n объектов типа Т, возможно, инициализирует каждый объект в этой памяти, и возвращает указатель типа Т*. delete p — разрушает объект, на который ссылается указатель p, и освобождает область памяти, выделенную для него ранее операцией new T. delete [] p — разрушает каждый объект в массиве, на который ссылается указатель p, и освобождает область памяти, выделенную для этого массива ранее операцией new T[n]. Операция delete проверяет, что её аргумент не NULL, в противном случае она ничего не делает. Операции new и delete вызывают конструкторы и деструкторы (см. ниже). Функции могут принимать аргументы по ссылке. Например, функция void f(int& x) {x=3;} присваивает своему аргументу значение 3. Функции также могут возвращать результат по ссылке, и ссылки могут быть вне всякой связи с функциями. Например, {double&b=a[3]; b=sin(b);} эквивалентно a[3]=sin(a[3]);. Ссылки в определённой степени сходны с указателями, со следующими особенностями: при описании ссылки инициализируются указанием на существующее значение данного типа; ссылка пожизненно указывает на один и тот же адрес; при обращении к ссылке операция * производится автоматически. Могут быть несколько функций с одним и тем же именем, но разными типами или количеством аргументов (перегрузка функций; при этом тип возвращаемого значения на перегрузку не влияет). Например, вполне можно писать: void Print(int x); void Print(double x); void Print(int x, int y); Один или несколько последних аргументов функции могут задаваться по умолчанию. К примеру, если функция описана как void f(int x, int y=5, int z=10) , вызовы f(1), f(1,5) и f(1,5,10) эквивалентны. При описании функций отсутствие аргументов в скобках означает, в отличие от Си, что аргументов нет, а не то, что они неизвестны. Если аргументы неизвестны, надо пользоваться многоточием, например int printf(const char* fmt, ...) Тип первого аргумента должен быть задан. Можно описывать операции над новыми типами. К примеру, так: struct Date {int day, month, year;}; void operator ++(struct Date& date); Операции ничем не отличаются от (других) функций. Нельзя описывать операции над предопределёнными типами (скажем, переопределять умножение чисел); нельзя выдумывать новые операции, которых нет в Си++ (скажем, ** ); арность (количество параметров) и приоритет операций сохраняется (скажем, в выражении a+b*c сначала будет выполняться умножение, а потом сложение, к каким бы типам ни принадлежали a, b и c.) Можно переопределить операции [] (с одним параметром) и () (с любым числом параметров). Добавлены пространства имён namespace. Например, если написать namespace Foo { const int x=5; typedef int** T; void f(y) {return y*x}; double g(T); ... } то вне фигурных скобок мы должны обращаться к T,x,f,g как Foo::T, Foo::x, Foo::f, Foo::g. Если мы в каком-то файле хотим обращаться к ним непосредственно, мы можем написать using namespace Foo; Или же using Foo::T; Пространства имён нужны, чтобы не возникало коллизий между пакетами, имеющими совпадающие имена глобальных переменных, функций и типов. Специальным случаем является безымянное пространство имён namespace { ... } Все имена, описанные в нём, доступны в текущем файле и больше нигде, как если бы мы к каждому описанию приписали static. Добавлен новый тип bool , имеющий значения true и false . Операции сравнения возвращают тип bool . Выражения в скобках после if , while приводятся к типу bool . // означает, что вся оставшаяся часть строки является комментарием. Добавлены шаблоны (template). Например, template<class T> T Min(T x, T y) {return x<y?x:y;} определяет функцию Min для любых типов. Шаблоны могут задавать не только функции, но и типы. Например, template<class T> struct Array{int len; T* val;}; определяет массив значений любого типа, после чего мы можем писать Array<float> x; Введена стандартная библиотека шаблонов (STL, Standard Template Library), определяющая шаблоны и функции для векторов (одномерных массивов произвольной длины), множеств, ассоциативных массивов (map), списков, символьных строк, потоков ввода-вывода и другие шаблоны и функции. Если описана структура, класс (о классах см. ниже), объединение (union) или перечисление (enum), её имя является именем типа, например: struct Time{int hh,mm,ss;}; Time t1, t2; Внутри структуры или класса можно описывать новые типы, как через typedef, так и через описание других структур или классов. Для доступа к таким типам вне структуры или класса, к имени типа добавляется имя структуры и два двоеточия: struct S {typedef int** T; T x;}; S::T y;
-
История языка С++ Бьерн Страуструп начал работать над «Си с классами» в 1979 году. Идея создания нового языка берёт начало от опыта программирования Страуструпа для диссертации. Он обнаружил, что язык моделирования Симула, имеет такие возможности, которые были бы очень полезны для разработки большого программного обеспечения, но работает слишком медленно. В то же время язык BCPL достаточно быстр, но слишком близок к языкам низкого уровня и не подходит для разработки большого программного обеспечения. Страуструп начал работать в «Bell Labs» над задачами теории очередей (в приложении к моделированию телефонных вызовов). Попытки применения существующих в то время языков моделирования оказались неэффективными. Вспоминая опыт своей диссертации, Страуструп решил дополнить язык Си (преемник BCPL) возможностями, имеющимися в языке Симула. Язык Си, будучи базовым языком системы UNIX, на которой работали компьютеры «Bell» является быстрым, многофункциональным и переносимым. Страуструп добавил к нему возможность работы с классами и объектами. В результате, практические задачи моделирования оказались доступными для решения как с точки зрения времени разработки (благодаря использованию Симула - подобных классов) так и с точки зрения времени вычислений (благодаря быстродействию Си). В начале в Си были добавлены классы (с инкапсуляцией), производные классы, строгая проверка типов, inline-функции и аргументы по умолчанию. Разрабатывая Си с классами (позднее Си++), Страуструп также написал программу Cfront, транслятор, перерабатывающий исходный код Си с классами в исходный код простого Си. Новый язык, неожиданно для автора, приобрел большую популярность среди коллег и вскоре Страуструп уже не мог лично поддерживать его, отвечая на тысячи вопросов. В 1983 г. произошло переименование языка из Си с классами в Си++ по соображениям маркетинга. Кроме того, в него были добавлены новые возможности, такие как виртуальные функции, перегрузка функций и операторов, ссылки, константы, пользовательский контроль над управлением свободной памятью, улучшенная проверка типов и новый стиль комментариев (//). Его первый коммерческий выпуск состоялся в октябре 1985 г.. В 1985 г. вышло первое издание «Языка программирования Си++», обеспечивающее первое описание этого языка, что было чрезвычайно важно из-за отсутствия официального стандарта. В 1989 г. состоялся выход Си++ версии 2.0. Его новые возможности включали множественное наследование, абстрактные классы, статические функции-члены, функции-константы и защищённые члены. В 1990 г. вышло «Комментированное справочное руководство по C++», положенное впоследствии в основу стандарта. Последние обновления включали шаблоны, исключения, пространства имён, новые способы приведения типов и булевский тип. Стандартная библиотека Си++ также развивалась вместе с ним. Первым добавлением к стандартной библиотеке Си++ стали потоки ввода/вывода, обеспечивающие средства для замены традиционных функций Си printf и scanf. Позднее самым значительным развитием стандартной библиотеки стало включение в неё Стандартной библиотеки шаблонов. После многих лет работы совместный комитет ANSI-ISO стандартизировал Си++ в 1998 г. (ISO/IEC 14882:1998). В течение нескольких лет после официального выхода стандарта комитет обрабатывал сообщения об ошибках и в итоге выпустил исправленную версию стандарта Си++ в 2003 году. Никто не обладает правами на язык Си++, он является свободным. Однако сам документ стандарта языка (за исключением черновиков) не доступен бесплатно.
-
История языка С++,будущее развитие,отличия С++ от С
-
Бобровский С. Самоучитель программирования на языке C++ в системе Borland C++Builder В этой книге вы познакомитесь с основными возможностями системы программирования Borland C++Builder производства корпорации Inprise. С ее помощью вам вполне по силам будет написание разнообразных настольных (desktop) приложений, таких, как электронные таблицы, персональные менеджеры, записные книжки, программы для составления расписания рабочего дня, файловые утилиты, не очень сложные мультимедийные приложения, обучающие программы, игры и многое другое. Самоучитель программирования на языке С++ в системе С++Build.rar

-
Давыдов В. Г. Технологии программирования C++ Рассмотрены объектно-ориентированная и обобщенная (с использованием стандартной библиотеки) технологии программирования, иллюстрируемые примерами решения классических задач прикладного программирования: сортировок массивов и файлов, транспортной задачи, поиска в таблице, обработки списков и работы с очередями. В качестве базового используется язык программирования высокого уровня C++. Подробно рассматривается стандартная библиотека языка C++. В пособие и компакт-диск включены демонстрационные программы, вопросы и упражнения для самопроверки с ответами, тесты и задания для курсового проектирования, а также справочная информация по C++. Давыдов В. Г. Технологии программирования C++.rar

-
Сделал часы. Показывают время в 4 городах. Лондон, Москва, Токио, Нью-Йорк. И можно менять внешний фон. Если надо можно доработать вставить календарь и еще можно добавить даты когда "основные" страны отдыхают. Например НГ или Рождество когда Американские биржи не работают. В clock.cl настойки. mygorod=Москва показывает название твоего города на 5-ых часах, GMT=3 -это GMT того места где ты живешь(у меня московское время), numer=1- это картинка(заставка)возможные значения 1 и 2, 0 нет картинки. часы.rar
-
Практическое занятие №3 Экспорт котировок с помощью индикатора BidAsk (Вступление) На этом практическом занятии с помощью индикатора BidAsk мы получим котировки 5 валютных пар в реальном времени. Котировки будем получать по следующим валютным парам EUR/USD, GBP/USD, AUD/USD, USD/CAD, USD/CHF. Для каждой валютной пары будем получать в определенный момент времени две цены, цену покупки и цену продажи. И так, для начала скачиваем и распаковываем индикатор BidAsk. BidAsk.rar Копируем распакованный файл в папку с индикаторами. У меня она располагается по пути C:\Program Files\MetaTrader 4\experts\indicators После копирования запускаем MetaTrader и в пользовательских индикаторах видим появившийся BidAsk. Выолняем его на любом из графиков (минутный это или часовой значения не имеет). После выполнения индикатора на графике видимых изменений на графике не произойдет. Принцип работы данного индикатора -это получение котировок в реальном времени и запись их в текстовой файл. Текстовой файл будет находиться по пути C:\Program Files\MetaTrader 4\experts\files и будет называться BidAsk.txt Давайте откорем этот файл и посмотрим, что записал туда индикатор. Вот, что у меня получилось. Теперь давайте разберемся что записал индикатор. 1.454 - это первая строчка Bid пары EUR/USD, 1.4542 -это вторая строчка Ask пары EUR/USD и так далее по всем 5 валютным парам в последовательности EUR/USD, GBP/USD, AUD/USD, USD/CAD, USD/CHF. Теперь нам нужно будет во время разработки программы открыть этот файл, прочитать котировки и вывести их в программе.


-
Вайнер Р. С++ изнутри Эта книга представляет собой набор примеров с сопровождающими объяснениями, которые иллюстрируют наиболее важные возможности языка С++ версии 2.0 с концентрацией на решение объектно-ориентированных проблем. Программисты, желающие использовать С++, смогут значительно ускорить процесс изучения, если будут иметь перед глазами хорошо написанные программы, сопровождаемые ясными комментариями, которые позволяют шаг за шагом освоить приемы программирования на С++. Основная цель книги состоит в демонстрировании преимуществ объектно-ориентированного программировании и в поощрении использования объектно-ориентированных возможностей С++. Подробно рассматриваются новейшие возможности С++, включая множественное наследование, которому посвящен целый раздел, содержащий множество примеров. В книге имеется рад вопросов "что если", которые предвосхищают те вопросы, которые могут возникнуть у читателя. Эти вопросы позволяют более детально изучить рассматриваемый предмет. Целью книги является дополнение растущего множества книг по С++. Эта книга предназначена для профессиональных программистов, специалистов по компьютерам, студентов, изучающих компьютеры, руководителей групп программистов и инженеров желающих в полной мере использовать возможности языка С++. Р.Вайнер С++ Изнутри.rar

-
Культин Н. С/С++ в задачах и примерах. Сборник задач по программированию на языке C/C++, как типовых - ввод-вывод, управление вычислительным процессом, работа с массивами, поиск и сортировка, так и тех, которые чаще всего не входят в традиционные курсы - работа со строками и файлами, вывод напринтер, деловая графика, рекурсия. Для большинства задач приведены решения, представляющие собой документированные исходные тексты программ. Книга содержит также справочник по наиболее часто используемым функциям языка C/C++ и может служить задачником для студентов и школьников, изучающих программирование. Культин_С_С++_в задачах и примерах.rar

-
Вот второй вариант заставки для "Дневника Трейдера" Заставка 2.rar"
-
Вот сделал заставочку для "Дневника трейдера" Заставка.rar